

Google готує новий механізм керування використанням контенту сайтів для навчання ШІ
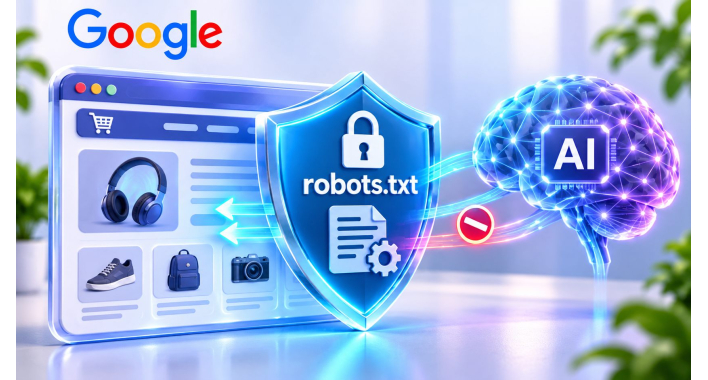
30 жовтня 2026 року Google оголосив про плани підтримати новий механізм, який дозволить власникам сайтів керувати використанням їхнього контенту для навчання штучного інтелекту. Передбачається, що відповідні налаштування можна буде задавати через файл robots.txt, використовуючи спільний сигнал для кількох постачальників ШІ.
Ініціатива покликана спростити управління доступом до вебконтенту. Замість окремих інструкцій для кожної компанії власники ресурсів зможуть висловлювати загальні побажання щодо навчання моделей штучного інтелекту.
Що саме планує змінити Google
Сьогодні компанії, які розробляють генеративний штучний інтелект, можуть використовувати різні механізми керування доступом до матеріалів сайтів. Через це вебмайстрам доводиться розбиратися в окремих правилах і налаштуваннях для різних сервісів.
Google планує підтримати спільний механізм, над яким працює група AIPREF у межах Internet Engineering Task Force (IETF) — міжнародної організації, що займається розробленням технічних стандартів інтернету.
Основна ідея полягає у використанні спеціального сигналу, який дозволить власнику сайту висловити загальну позицію щодо використання його матеріалів для навчання ШІ. Такий підхід потенційно спростить управління контентом для інформаційних порталів, комерційних сайтів, інтернет-магазинів та інших вебресурсів. Водночас Google наголошує, що йдеться про механізм, який ще розробляється. Його практичні можливості залежатимуть від підтримки з боку інших учасників ринку.
Як працюватиме новий механізм у robots.txt
Файл robots.txt традиційно використовується для керування скануванням вебресурсу автоматизованими роботами. Він дозволяє задавати правила доступу до окремих розділів і сторінок сайту для роботів, які підтримують відповідний протокол.
Новий механізм передбачає використання спільного policy token — спеціального сигналу, за допомогою якого сайт зможе повідомити про небажання надавати свій контент для навчання моделей ШІ. Згідно з анонсом Google, якщо власник сайту за допомогою цього сигналу заборонить використання матеріалів для навчання, а окремих інструкцій для Google-Extended не буде, компанія планує трактувати таке налаштування як заборону для Google-Extended.
Інші постачальники штучного інтелекту зможуть застосовувати аналогічний підхід. При цьому індивідуальні налаштування залишаться доступними. Скажімо, власник ресурсу зможе встановити загальне обмеження, але окремо визначити правила для Google через Google-Extended. Це важливо, оскільки різні компанії можуть мати власні механізми обробки контенту, а універсальний сигнал не обов'язково означатиме однакову поведінку всіх ШІ-сервісів.

Чи вплине новий механізм на індексацію сайту в Google
Одне з головних питань для власників вебресурсів — чи впливатиме заборона використання контенту для навчання ШІ на присутність сайту в пошуковій видачі.
Тут важливо розрізняти три процеси:
- Сканування сайту — отримання роботами доступу до сторінок та їхнього вмісту.
- Індексація сайту — обробка сторінок і можливе включення інформації про них до пошукового індексу.
- Навчання штучного інтелекту — використання даних для створення або вдосконалення моделей ШІ.
Ці процеси можуть використовувати схожі джерела інформації, але мають різне призначення. Зокрема, Google-Extended є окремим механізмом керування використанням контенту для певних завдань, пов'язаних зі штучним інтелектом. Його налаштування не тотожне забороні індексації сторінок у Google Search.
Водночас Google зазначає, що сайти, які явно дозволяють Google-Extended, можуть претендувати на появу в результатах із посиланнями на джерела в застосунках Gemini. Тому рішення про обмеження доступу потребує оцінки не лише з погляду захисту матеріалів, а й потенційної видимості контенту в ШІ-сервісах.
Для пошукової оптимізації важливо не плутати ці налаштування. Докладніше про підготовку сторінок до індексації, перевірку технічних параметрів і роботу з текстовими матеріалами розповідається в матеріалі Dash Agency про SEO-оптимізацію контенту.
Отже, майбутній механізм не слід розглядати як заміну звичайним інструментам SEO або правилам індексації.
Що зміниться для власників сайтів
Якщо спільний стандарт отримає широку підтримку, адміністрування вебресурсів може стати простішим. Власникам сайтів не доведеться налаштовувати однакові обмеження окремо для кожного постачальника штучного інтелекту, який підтримуватиме новий сигнал.
Найбільш помітні переваги можуть отримати ресурси, для яких оригінальний контент є важливою частиною бізнесу:
- Інформаційні видання. Зможуть простіше висловлювати свою позицію щодо використання авторських матеріалів для навчання ШІ.
- Комерційні сайти. Отримають додатковий інструмент керування використанням текстів, описів послуг та інших матеріалів.
- Інтернет-магазини. Зможуть визначати загальні правила використання товарних описів та інформаційного контенту для навчання моделей.
- Освітні платформи. Матимуть можливість централізовано задавати побажання щодо використання навчальних матеріалів.
Проте важливо розуміти обмеження технології. Файл robots.txt передає інструкції автоматизованим системам, але сам собою не створює технічного бар'єра, який фізично унеможливлює отримання контенту.
Дотримання правил залежатиме від конкретного постачальника ШІ та його підтримки нового механізму. Тому спільний сигнал не варто сприймати як універсальну гарантію захисту авторських прав або повного припинення використання матеріалів третіми сторонами.
Чому ініціатива важлива для розвитку штучного інтелекту
Поширення генеративного штучного інтелекту загострило питання про те, як розробники моделей використовують інформацію з відкритого інтернету. Власники сайтів зацікавлені в тому, щоб їхні матеріали залишалися доступними користувачам і пошуковим системам, але водночас прагнуть контролювати інші способи використання контенту. Новий механізм має допомогти розмежувати ці завдання.
За інформацією Google, пропозиція враховує позиції видавців, громадських організацій, регуляторів та інших учасників обговорення. Вона також узгоджується з підходом, закріпленим у Кодексі практики для постачальників моделей ШІ загального призначення в межах європейського AI Act.
При цьому робота над ширшим набором правил AIPREF триває. Запропонований механізм є одним з етапів формування спільного підходу, а не завершеним універсальним стандартом для всіх випадків використання вебконтенту.
Коли Google планує запровадити новий механізм
Google повідомив про намір підтримати новий механізм разом з іншими постачальниками штучного інтелекту у 2027 році. Точну дату запуску поки не оголошено. Компанія обіцяє інформувати про подальший розвиток ініціативи.
Станом на початок листопада 2026 року власникам сайтів не потрібно терміново змінювати robots.txt через цей анонс. Насамперед варто стежити за офіційними рекомендаціями та появою остаточних технічних специфікацій.
Якщо ресурс уже використовує Google-Extended або інші індивідуальні правила для ШІ-роботів, їх слід оцінювати окремо. Google планує зберегти можливість таких налаштувань поряд із майбутнім спільним сигналом.
Що означають зміни Google для власників сайтів
Google зробив крок до створення більш універсального механізму керування використанням вебконтенту для навчання штучного інтелекту. Запропонований підхід дозволить власникам сайтів висловлювати загальні побажання через robots.txt, не налаштовуючи однакові обмеження окремо для кожного постачальника ШІ.
Однак остаточна ефективність ініціативи залежатиме від того, скільки компаній підтримають спільний сигнал і наскільки послідовно виконуватимуть відповідні правила.
Для власників сайтів головне зараз — розуміти відмінність між пошуковою індексацією та використанням контенту для навчання ШІ, а також стежити за розвитком нового стандарту до його запланованого впровадження у 2027 році.
Заходьте до наших каталогів (за типом компаній):
- SMM агентства
- SEO компанії
- PPC компанії
- Веб-студії
- Mobile агентства
- Digital агентствa
- IT компанії
- Та інші менш популярні каталоги
та вибирайте партнера за рядом критеріїв: бал, портфоліо, відгуки, кейси та статті. Або організуйте тендер в даному каталозі, вибравши компанії, що вам сподобалися.
У каталозі 1700+ діджитал-агентств, які готові допомогти в реалізації ваших завдань. Вибирайте та економте до 30% свого часу та бюджету! Це безкоштовно та займе менше 3-х хвилин.